Introdução e Objetivo do Estudo
Dando continuidade ao nosso estudo sobre a viabilidade de Modelos de Linguagem de Borda (SLMs) em hardware de consumo comum, este segundo artigo eleva o nível da infraestrutura. Deixamos de lado o ambiente virtualizado e limitado de notebooks legados para analisar uma plataforma de processamento pesado de baixo custo: o aclamado "Kit Xeon" do AliExpress.
O objetivo deste laboratório foi puramente arquitetural: destrinchar a curva de eficiência de threads em processadores multicore, identificar o impacto físico da largura de banda da memória RAM (Single-Channel vs. Dual-Channel) na taxa de geração de texto e avaliar como o estrangulamento do barramento afeta a estabilidade lógica e cognitiva de uma Inteligência Artificial operando de forma 100% local e offline.
Metodologia e Especificações da Bancada
Para eliminar qualquer perda de desempenho por camadas de abstração, removemos a virtualização por contêineres e executamos o ecossistema diretamente sobre o metal.
A. A Engenharia do Hardware (Investimento Total: R$ 1.530,00)
- Processador, Placa-Mãe e Cooler: Intel Xeon E5-2676v3 (12 núcleos físicos / 24 threads via Hyper-Threading, arquitetura Haswell-EP) + Placa X99-PR3 + Air Cooler — R$ 500,00
- Memória RAM: 64 GB distribuídos em 2 pentes de 32GB Hynix LRDIMM DDR3 4Rx4 14900L (Módulos de alta densidade para servidores em Quad-Rank) — R$ 500,00
- Armazenamento: SSD SATA Consumer de 480GB — R$ 300,00
- Fonte de Alimentação: Mancer 400W — R$ 170,00
- Gabinete: Modelo básico padrão — R$ 60,00
B. Pilha de Software e Parâmetros de Controle
- Sistema Operacional: Windows 11 Pro.
- Motor de Inferência: Ollama instalado via Windows Installer nativo (utilizando instruções vetoriais AVX2 via llama.cpp).
- Interface e Logs: Open WebUI versão Desktop.
- O Teste de Estresse Cognitivo (Prompt Padrão): "Pode me ajudar a montar um planejamento de viagem pela europa, passando por portugal, espanha, italia e grecia?"
Matriz de Resultados Absolutos (O Placar Geral da Bancada)
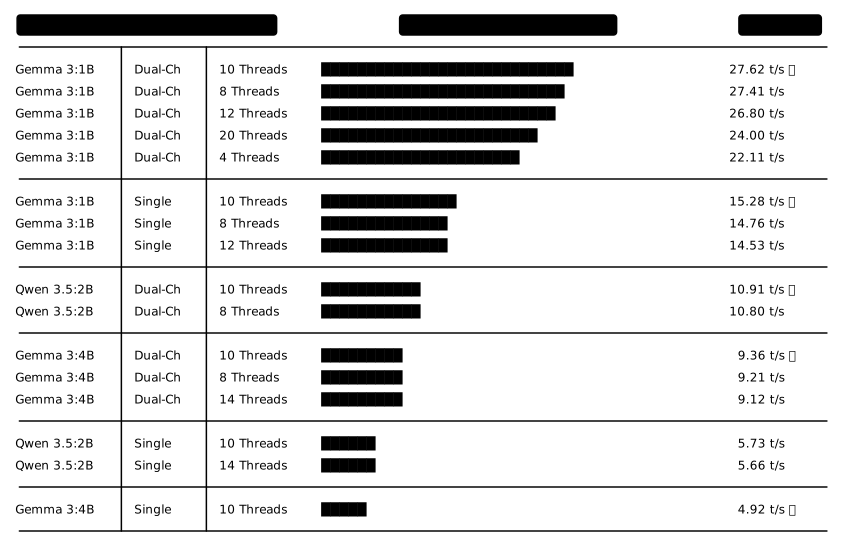
Os dados abaixo foram colhidos de forma empírica e cirúrgica, alterando a alocação de threads diretamente no interpretador do Ollama e alternando a disposição física dos pentes de memória para isolar os barramentos:
| Posição | Modelo | Canais de Memória | Threads Alocadas | Velocidade Média | O que tem de BOM (Pontos Fortes) | Pontos Fracos (Limitações / Comportamento nos Testes) |
| 1º 🥇 | Gemma 3:1B | Dual (2x32GB) | 10 Threads | 27.62 tokens/s 🚀 | Recorde de Velocidade: Resposta instantânea, fluida e natural. Excelente curadoria regional (Toledo/Algarve). | Pequenos deslizes secundários de digitação ao correr. |
| 2º 🥈 | Gemma 3:1B | Dual (2x32GB) | 8 Threads | ~27.41 tokens/s | Máxima Estabilidade de 1B: Corrigiu a logística das ilhas gregas (voos/ferries) e trouxe links de utilidade reais (Rome2Rio). | Pequeno erro de contagem no cabeçalho inicial. |
| 3º 🥉 | Gemma 3:1B | Dual (2x32GB) | 12 Threads | ~26.80 tokens/s | Uso Limpo dos Cores: Distribuição regionalizada coerente de cidades históricas latinas. | Sugestão genérica de trens na Grécia. |
| 4º | Gemma 3:1B | Dual (2x32GB) | 20 Threads | ~24.00 tokens/s | Estrutura Longa: Conseguiu manter o contexto de um roteiro massivo de 48 dias. | Gargalo por Hyper-Threading; misturou fronteiras (Roma na Espanha). |
| 5º | Gemma 3:1B | Dual (2x32GB) | 4 Threads | ~22.11 tokens/s | Modularidade: Detalhou o orçamento por categorias de custos de forma limpa. | Perda de paralelismo trouxe neologismos ("Pnúcia"). |
| 6º | Gemma 3:1B | Single (1x32GB) | 10 Threads | ~15.28 tokens/s | Organização Visual: Manteve seções temáticas de dicas de viagem por cidade. | Asfixia de RAM: Perda de 44% de velocidade. Sugeriu jogar Polo em Santorini e ver a Muralha de Adriano(UK) na Grécia. |
| 7º | Gemma 3:1B | Single (1x32GB) | 8 Threads | ~14.76 tokens/s | Estrutura por País: Manteve o orçamento dividido por moedas de forma modular. | Asfixia de RAM: Delírios e colapso na conversão monetária (trocar Euros por Libras). |
| 8º | Gemma 3:1B | Single (1x32GB) | 12 Threads | ~14.53 tokens/s | Tópicos Limpos: Conseguiu enumerar os dias de forma sequencial na tela. | Saturação de Barramento: Menor velocidade da categoria 1B devido a filas de espera na CPU. |
| 9º | Gemma 3:4B | Dual (2x32GB) | 10 Threads | 9.36 tokens/s ⏱️ | O Rei da Inteligência: Abordagem consultiva brilhante (perguntas de triagem). Cenários de 15 e 30 dias reais. Zero alucinações. | Velocidade amarrada pelo tamanho do modelo, mas altamente utilizável. |
| 10º | Gemma 3:4B | Dual (2x32GB) | 8 Threads | ~9.21 tokens/s | Precisão Enciclopédica: Excelente mapeamento de atrações finas (Monte Licabeto, Trastevere, Casa Milà). | Levemente mais lento do que com 10 threads devido ao peso matemático. |
| 11º | Gemma 3:4B | Dual (2x32GB) | 14 Threads | ~9.12 tokens/s | Roteiro Cadenciado: Refinou o tempo em Sintra (2 dias) e manteve consistência linguística. | Queda de rendimento por Hyper-Threading e sugestão vaga de trem entre Espanha e Itália. |
| 12º | Qwen 3.5:2B (Com CoT) | Dual (2x32GB) | 10 Threads | ~10.91 tokens/s | Tempo de CoT Reduzido: O pensamento caiu de 41s para 18s graças ao Dual-Channel. | Pane de Sequestro de Escopo: O modelo focou 100% em ferramentas do sistema e recusou-se a escrever o roteiro. |
| 13º | Qwen 3.5:2B (Com CoT) | Dual (2x32GB) | 8 Threads | ~10.80 tokens/s | Ganho de Vazão: Escreveu o texto rápido na tela após a Chain of Thought. | Delírio Geográfico Grave: Moveu a cidade de Santarém (Portugal) para a Grécia e inventou as "Pirâmides das Caimans". |
| 14º | Gemma 3:4B | Single (1x32GB) | 10 Threads | ~4.92 tokens/s | Links Reais: Manteve as URLs úteis de viagem intactas (Booking, Rome2Rio). | Asfixia de Parâmetros: Queda de 47% de velocidade, jogando o modelo de volta para a zona de lentidão. |
| 15º | Qwen 3.5:2B (Com CoT) | Single (1x32GB) | 10 Threads | ~5.73 tokens/s | Cronologia: Montou uma lista de dias numerados na tela. | Moveu a Cidade do México para a Espanha e a Capela Sistina para Bolonha. |
| 16º | Qwen 3.5:2B (Com CoT) | Single (1x32GB) | 14 Threads | ~5.66 tokens/s | Transparência: Explicou de forma clara as suas limitações técnicas de sistema. | Entrou em loop de metalinguagem sobre botões e sugeriu o evento "Mercado na Floresta". |
Discussão e Descobertas Arquiteturais
A. A Ilusão do Hyper-Threading e o Efeito de Contenção (Thread Contention)
O senso comum de hardware assume que alocar o maior número de threads lógicas (24 threads no caso do Xeon v3) extrairia o máximo desempenho. Nosso benchmark provou o oposto. Ao forçar a execução com o Hyper-Threading ativado em capacidade quase máxima (como no teste com 20 threads), múltiplos fluxos virtuais passaram a compartilhar recursos de execução de ponto flutuante dentro do mesmo núcleo físico. Isso gerou um atraso considerável por troca de contexto (context switching), além de uma disputa agressiva por memória, derrubando a performance para 24.00 tokens/s.
O "ponto doce" (sweet spot) do processador foi encontrado em 10 threads. Ao utilizarmos menos do que o limite de 12 núcleos físicos reais da CPU, deixamos núcleos totalmente livres para gerenciar as demandas do sistema operacional Windows 11 e do Open WebUI Desktop. Essa folga arquitetural eliminou a disputa de cache L3 e permitiu que o processador elevasse a frequência de clock (Turbo Boost) ao patamar máximo permitido por núcleo ativo, destravando o recorde de 27.62 tokens/s no Gemma 3:1B.
B. Memory-Bound versus Compute-Bound nos Modelos SLM
A dinâmica de threads revelou a diferença de comportamento matemático entre as variantes de tamanho:
- Gemma 3:1B (Memory-Bound): Por ter uma matriz de parâmetros leve, ele processa os cálculos matemáticos de forma instantânea e passa a maior parte do ciclo de clock esperando a memória entregar dados. Por isso, reduzir de 12 para 8 threads quase não alterou sua velocidade (de 26.80 para 27.41 tokens/s), já que o gargalo era puramente físico do barramento de memória.
- Gemma 3:4B (Compute-Bound): Possuindo quase quatro vezes mais densidade matemática por token gerado, as operações de matrizes dividem o protagonismo com o barramento. Por essa razão, ele escalou positivamente com o acréscimo de núcleos reais, saltando de 9.21 tokens/s (8 threads) para seu ápice de 9.36 tokens/s (10 threads), perdendo rendimento imediatamente ao sofrer a interferência do Hyper-Threading (14 threads).
C. O Veredito Científico: Largura de Banda de RAM dita a Sanidade da IA
O xeque-mate do estudo ocorreu ao removermos fisicamente um dos pentes de memória, forçando o hardware a operar em Single-Channel (1x32GB) e cortando a taxa de transferência de dados pela metade.
No modelo de 1B, a performance desabou de 27.62 tokens/s para 15.28 tokens/s (uma perda massiva de 44,6%). No modelo de 4B, o impacto foi ainda mais violento, caindo de 9.36 tokens/s para 4.92 tokens/s (uma queda drástica de 47,4%). Isso prova empiricamente que quanto maior a densidade de parâmetros de um LLM, maior é a sua dependência física de um barramento de dados largo.
O reflexo mais alarmante, no entanto, foi o colapso cognitivo provocado pelo gargalo de RAM. Sob o estresse do atraso na busca de dados na memória, os pesos dos modelos perderam estabilidade de contexto. O Gemma 3:1B passou a operar delírios factuais absurdos, como sugerir partidas de pólo na ilha de Santorini e mover a Muralha de Adriano (Reino Unido) para a Grécia. O colapso atingiu o ápice com o Qwen 3.5:2B em Single-Channel, que sob estresse de memória anexou a Cidade do México ao território da Espanha e teletransportou as Pirâmides do Egito para o centro de Atenas. Quando os canais de memória são asfixiados, o atraso de dados corrompe a própria lógica do raciocínio interno do modelo.
A Projeção do Próximo Nível: O Poder Oculto do Quad-Channel
Embora a placa-mãe utilizada neste teste específico (X99-PR3) limite o barramento ao Dual-Channel físico (o que já garantiu os excelentes 27.62 tokens/s no Gemma 1B), a arquitetura dos processadores Intel Xeon E5 v3 esconde um trunfo que muda as regras do jogo: o suporte nativo a Quad-Channel real.
No mercado atual de plataformas recicladas, um investimento marginal de apenas R$ 100 a mais permite substituir a placa-mãe básica por modelos ligeiramente mais robustos, como a X99-XD3 ou XD4 ou similares com 4 ou 8 slots de memória reais. Ao espalhar os mesmos 64GB de RAM LRDIMM em quatro módulos idênticos (4x16GB) para ativar o Quad-Channel, a largura de banda teórica de transferência de dados dobra novamente, saltando da faixa de ~34 GB/s para impressionantes ~68 GB/s.
Essa métrica de largura de banda coloca um computador completo de R$ 1.650,00 a R$ 1.700,00 em patamar de igualdade direta com o barramento de memória de desktops modernos topo de linha operando com memórias DDR5 em Dual-Channel convencional (que giram em torno de 50 a 65 GB/s em frequências padrão).
Como os modelos compactos locais (SLMs) são totalmente limitados pela velocidade de leitura da RAM (memory-bound), o Quad-Channel em memórias DDR3 de servidor anula a desvantagem geracional do hardware de 2017. Ele permite que uma máquina "Frankenstein" de baixo custo alimente os núcleos da CPU sem qualquer retenção de dados, empurrando as taxas do Gemma 3:1B para além dos 35-40 tokens/s e estabilizando o Gemma 3:4B em patamares de altíssima interatividade — uma eficiência que, até então, o mercado acreditava ser exclusividade de hardwares super caros de última geração ou chips proprietários unificados.
Conclusão e Viabilidade Comercial
O estudo de caso consolidado em nossa bancada de R$ 1.530,00 redesenha o entendimento sobre a Inteligência Artificial local de baixo custo. A inferência de SLMs na CPU não é uma questão de força bruta computacional, mas sim de equilíbrio e harmonia de arquitetura.
Muitos usuários assumem que para extrair respostas úteis de modelos de ponta locais, é obrigatório investir em assinaturas caras de nuvem ou em GPUs dedicadas que sozinhas ultrapassam a marca dos R$ 3.000,00. Nosso laboratório prova o contrário. Montamos uma plataforma baseada em hardware de servidor reciclado gastando exatamente R$ 1.530,00.
Ao otimizarmos as linhas de execução para 10 threads físicas em Dual-Channel, destravamos 27.62 tokens/s com privacidade total, zero mensalidades e zero dependência de internet.
A conclusão é implacável: travar o motor do Ollama na faixa cirúrgica de 10 threads físicas e garantir a ativação do barramento em Dual-Channel com memórias de alta densidade (Quad-Rank) é o único caminho para manter o modelo de 1B ultra-rápido e garantir que a variante de 4B funcione com precisão enciclopédica absoluta e alta utilidade no cotidiano. No ecossistema de baixo custo, a estrada onde os dados viajam (RAM) importa muito mais do que a quantidade bruta de operários (núcleos).