Introdução e Objetivo do Estudo
A corrida pelo desenvolvimento de Modelos de Linguagem de Grande Porte (LLMs) gerou soluções corporativas massivas baseadas em nuvem. No entanto, o custo financeiro recorrente, a dependência de conexão à internet e as crescentes preocupações com a privacidade de dados impulsionaram o interesse por IAs de borda (On-Device/Edge AI).
O objetivo deste estudo foi avaliar o desempenho prático, a utilidade cotidiana e as capacidades cognitivas dos principais Modelos de Linguagem Pequenos (SLMs) do mercado, rodando de forma 100% local e offline. Buscou-se identificar quais modelos entregam a melhor experiência interativa para tarefas cotidianas em um hardware de uso comum, sem qualquer investimento em GPUs dedicadas ou chips modernos com aceleradores de IA.
Metodologia e Ambiente de Testes
Para garantir o isolamento do ambiente, a portabilidade e a facilidade de reprodução dos testes, utilizou-se uma infraestrutura baseada em contêineres sobre um sistema operacional macOS legado.
Especificações do Hardware:
- Dispositivo: Apple Mac Pro (Modelo 2017)
- Memória RAM: 16 GB DDR3 (Frequência padrão da geração)
- Processador (CPU): Intel Xeon / Core de arquitetura correspondente à geração 2017, sem aceleração gráfica unificada (Apple Silicon) ou NPU dedicada.
- Gargalo Arquitetural: Largura de banda restrita da memória RAM DDR3 para alimentar os registradores da CPU com os pesos quantizados dos modelos.
Arquitetura de Software (Pilha de Execução):
- Camada de Virtualização: Docker Desktop para Mac gerenciando o ciclo de vida dos contêineres.
- Motor de Execução de IA: Imagem oficial do Ollama rodando em contêiner, utilizando como backend o motor otimizado llama.cpp. A inferência foi executada utilizando instruções vetoriais da CPU (como AVX2 suportado pelo hardware).
- Interface de Usuário: Open WebUI implantado em um contêiner Docker separado, conectado à API local do Ollama, fornecendo um ecossistema visual fluido e registro de logs de processamento.
- Quantização dos Modelos: Todos os modelos testados utilizaram a quantização padrão do ecossistema Ollama (predominantemente Q4_K_M de 4 bits), reduzindo o tamanho de armazenamento e a ocupação em memória para patamares entre 500 MB e 2.5 GB.
O Teste de Estresse Cognitivo (Prompt Padrão):
Para medir o alinhamento de instrução, a persistência de contexto e a barreira linguística, todos os modelos foram submetidos ao mesmo prompt complexo em português brasileiro (PT-BR):
"Pode me ajudar a montar um planejamento de viagem pela europa, passando Portugal, Espanha, Itália e Grécia?"
Para modelos baseados em raciocínio hibridizado (Thinking Models), um segundo prompt foi aplicado para validar flexibilidade linguística e gerenciamento de contexto: "Pode traduzir para o português?".
Contexto Técnico e Dados Públicos dos Modelos
Antes de analisar os resultados empíricos, é fundamental mapear as especificações públicas e o propósito de design declarado pelos desenvolvedores para cada família de modelos avaliada:
- Família Gemma 3 (Google DeepMind): Projetada com o estado da arte em destilação de conhecimento da família Gemini. O grande trunfo público do Gemma 3 é o seu Tokenizador Multilíngue Avançado de 262.144 entradas, treinado nativamente em mais de 140 idiomas (incluindo o português de forma profunda) e sua janela de contexto de até 32K que utiliza uma arquitetura de Atenção Intercalada para otimizar o uso do KV Cache em memórias restritas.
- Família Llama 3.2 (Meta AI): Modelos compactos focados em alta eficiência e portabilidade para dispositivos móveis Android/iOS. Possuem uma janela de contexto de 128K, mas o vocabulário público de 128K tokens é altamente otimizado para o inglês, o que força o modelo a quebrar palavras em português em múltiplos sub-tokens (sub-word tokenization), gerando maior esforço computacional por caractere em nossa língua.
- Família Phi-3.5 e Phi-4-mini (Microsoft): Treinados intensivamente com a filosofia de "dados sintéticos de alta qualidade" (textbooks are all you need). São modelos altamente focados em raciocínio lógico puro, matemática e geração de código em inglês, deixando a naturalidade de línguas latinas como objetivo secundário de ajuste fino.
- Família Qwen 2.5 e Qwen 3 (Alibaba Cloud): Modelos líderes mundiais em benchmarks abertos de matemática e programação. A linha Thinking/Preview introduz uma arquitetura hibridizada de Cadeia de Pensamento (CoT - Chain of Thought) focada em agir como agentes autônomos (tool-use/function calling).
- Hermes 3 (Nous Research): Um ajuste fino (fine-tune) comunitário aclamado da arquitetura Llama/Qwen, otimizado especificamente para obediência estrita de prompts de sistema, escrita criativa, RPG e ausência de filtros corporativos rígidos.
- Orca-Mini (OpenOrca): Modelo gerado a partir de treinamento especializado imitando os rastros de pensamento de modelos proprietários gigantes. Seu foco público é a capacidade de síntese e utilidade textual direta.
Tabela Comparativa de Resultados Práticos
Os dados abaixo consolidam as métricas de velocidade extraídas diretamente da API do Ollama e a avaliação qualitativa do comportamento cognitivo de cada modelo frente ao hardware de memória DDR3:
🏆 Ranking Definitivo de LLMs Locais em CPU (Mac Pro 2017 - 16GB DDR3)
| Posição | Modelo | Desenvolvedor | Tamanho (Parâmetros) | Velocidade Média (CPU) | Qualidade do Idioma (PT-BR) | Pontos Fracos (Limitações / Comportamento nos Testes) |
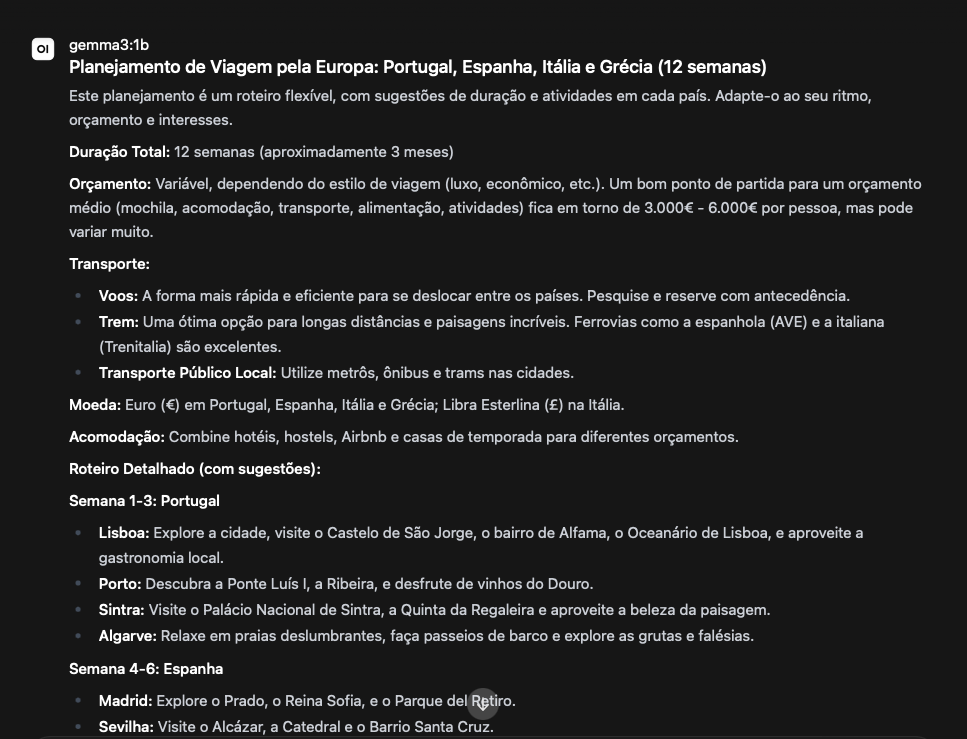
| 1º 🥇 | Gemma 3:1B | 1.0 Bilhão | ~10.7 tokens/s 🚀 | Perfeita: Fluida, nativa e natural. | Alucinações leves em dados factuais secundários (troca de moedas ou nomes de atrações). Único com "empatia de design" (Airbnb, ritmo). | |
| 2º 🥈 | Gemma 3:4B | 4.0 Bilhões | ~4.16 tokens/s 📊 | Excelente: Vocabulário rico e preciso, corrigindo alucinações. | Velocidade reduzida no hardware DDR3 e pequenos deslizes de digitação (manteve o título de Lisboa no bloco da Espanha). | |
| 3º 🥉 | Llama 3.2:1B | Meta | 1.0 Bilhão | ~6.3 tokens/s | Ruim: Erros de concordância e termos truncados. | Colapso factual severo: Inventou o Pão de Açúcar em Lisboa, o Louvre sem ir à França e quebrou a lógica do calendário. |
| 4º | Hermes 3:3B | Nous Research | 3.0 Bilhões | ~3.14 tokens/s | Regular: Português funcional, mas com termos traduzidos ao pé da letra. | Contaminação Linguística: Traz listas ricas de pontos turísticos, mas o português foi invadido pelo espanhol ("viaje", "planeta" para planejamento). |
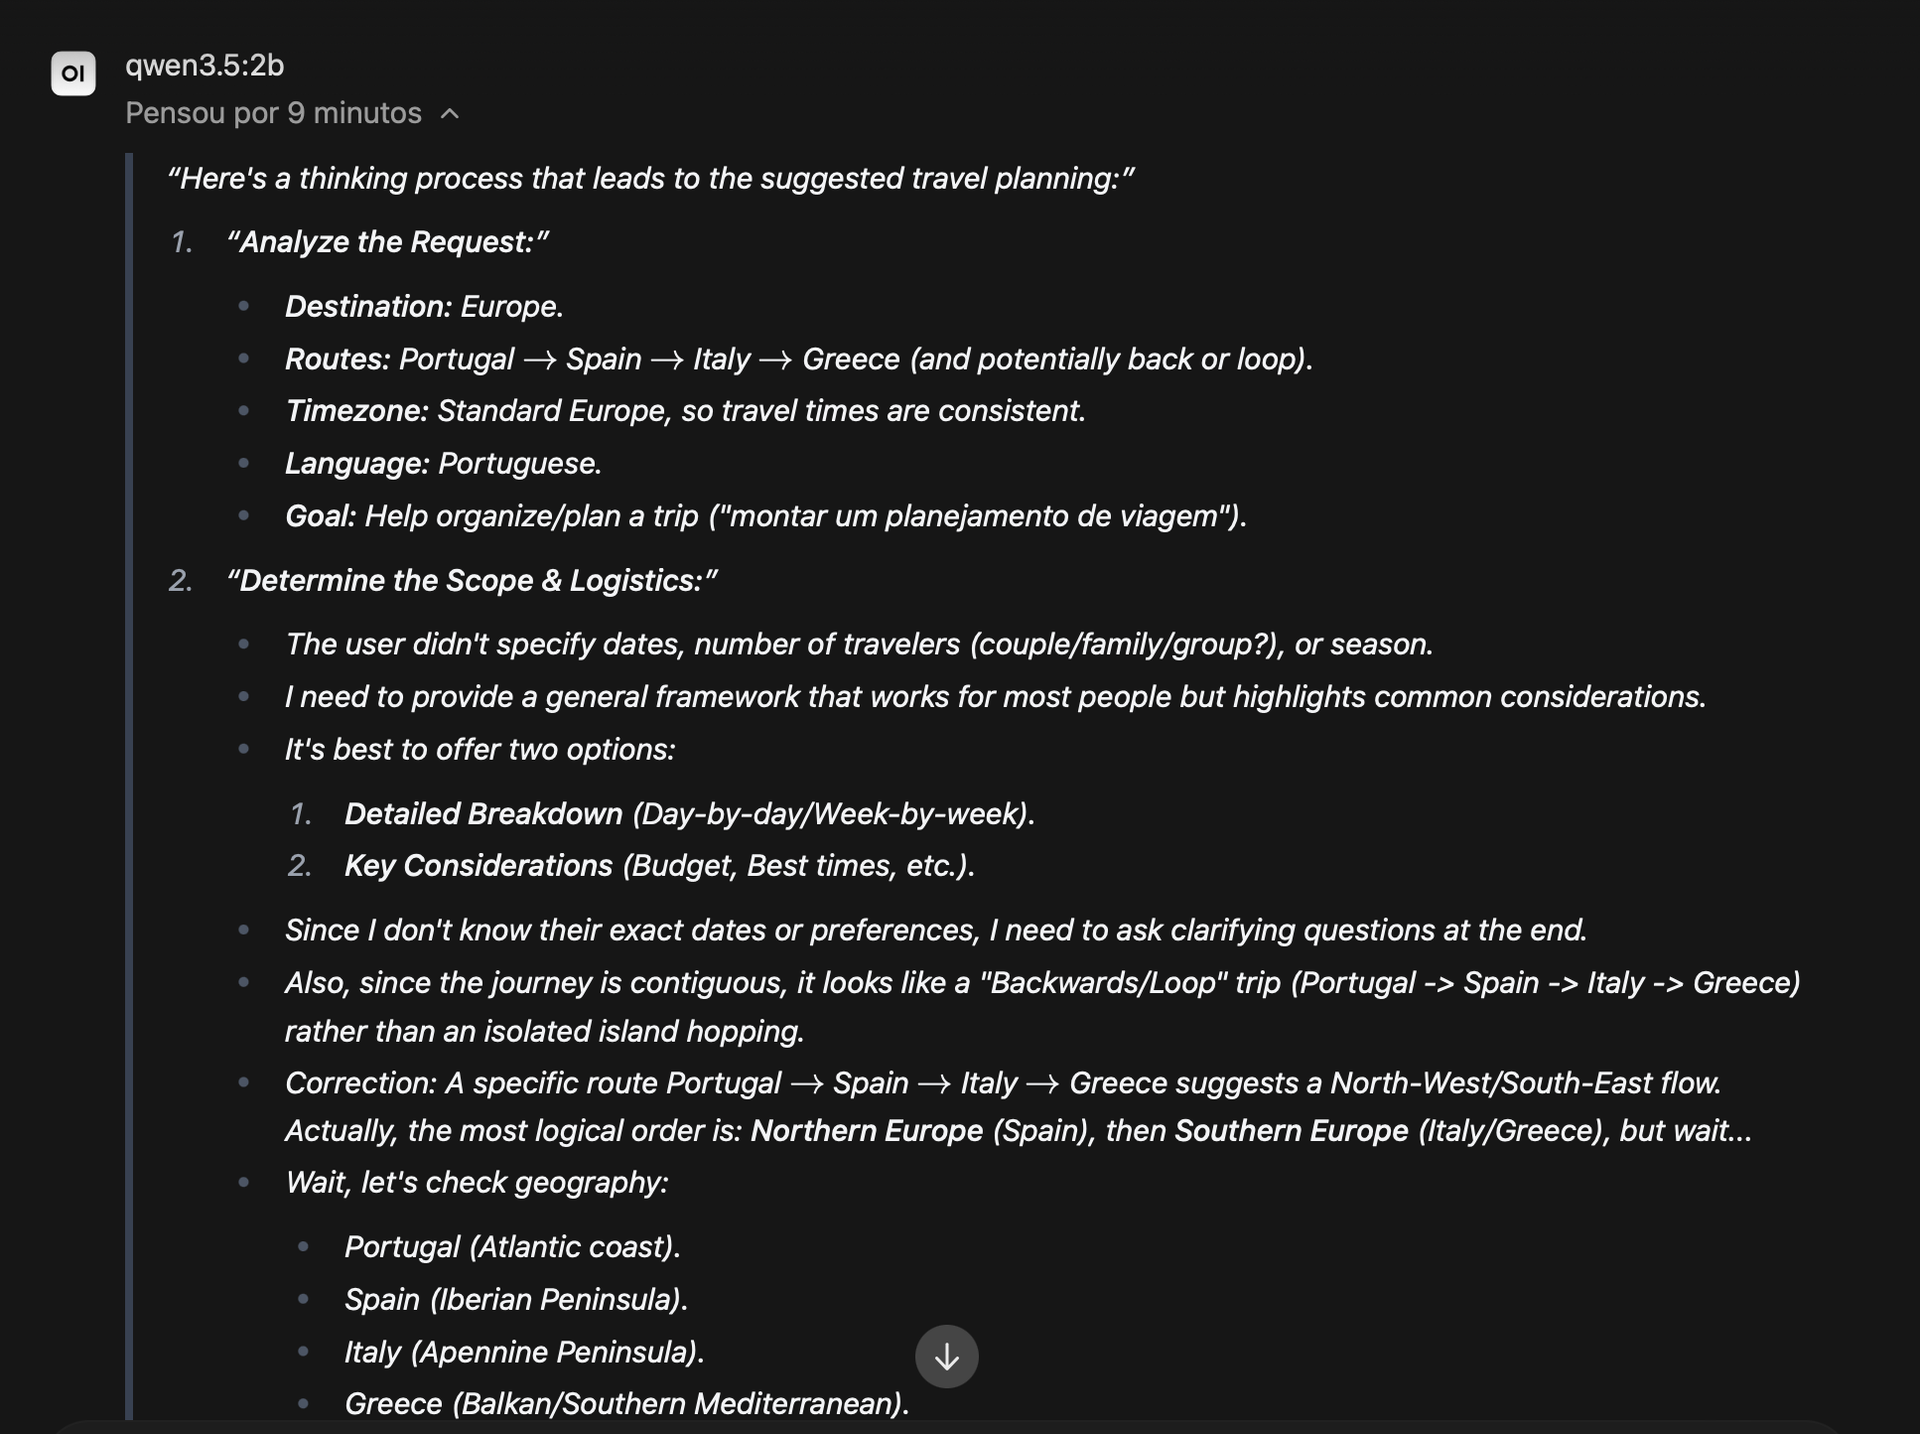
| 5º | Qwen 3.5:2B (Sem Tools / Com CoT) | Alibaba | 2.0 Bilhões | ~4.2 tokens/s | Boa: Obedeceu à regra final e traduziu a resposta após refletir. | Gargalo Extremo de Latência: Passou 9 longos minutos em silêncio gerando um monólogo interno caótico em inglês antes de começar a responder. |
| 6º | Phi-3.5 | Microsoft | 3.8 Bilhões | ~5.0 tokens/s | Horrível: Tradução mecanizada e robótica ("encontre acolchoados italianos"). | Confusa: Total colapso espacial; misturou atrações de Madrid dentro de blocos de texto sobre Portugal. |
| 7º | Llama 3.2:3B | Meta | 3.0 Bilhões | ~3.75 tokens/s | Regular: Linguagem muito rígida e traduzida de forma literal ("explore os praios"). | Dureza e Repetição: Repetições desnecessárias (Coliseu em dias alternados) e redundâncias (Piraeus e Pireas como cidades diferentes). |
| 8º | Phi-4-mini | Microsoft | 3.8 Bilhões | ~2.0 tokens/s | Regular: Tenta soar formal, mas o texto é bastante travado. | Roteiro Ioiô: Pesado demais para CPU DDR3 e sem lógica geográfica (mandou voltar para Lisboa de avião todas as noites). |
| 9º | Qwen 2.5:3b | Alibaba | 3.0 Bilhões | ~4.77 tokens/s | Nula / Travada | Loop de Funções: Entrou em pane tentando disparar uma automação fantasma de calendário, travando a resposta. |
| 10º | Orca-Mini:3b | OpenOrca | 3.0 Bilhões | ~5.16 tokens/s | Inexistente / Desastrosa | Apagão de Contexto: Ignorou o idioma original e, ao ser forçado a traduzir, perdeu o rastreamento do histórico e gerou frases desconexas. |
| 11º | Qwen 3.5:2B (Com Raciocínio / Com Tools) | Alibaba | 2.0 Bilhões | ~5.53 tokens/s (CoT) | Regular | Delírio Factual e Econômico Extremo: Passou 41s pensando em botões, inventou que Portugal usa "Real", Itália usa "Libra" e a Grécia usa "Drachma". |
| 12º | Qwen 3.5:2B (Sem Raciocínio) | Alibaba | 2.0 Bilhões | ~4.8 tokens/s | Regular | Loop Obsessivo e Perda de Foco: Gerou 25 dias de roteiro, mas esqueceu a Itália e a Grécia. Ficou preso viajando entre Porto e Lisboa. |
| 13º | Qwen 3:1.7B (Com Raciocínio) | Alibaba | 1.7 Bilhão | ~5.5 tokens/s (CoT) | Nula / Recusa | Overthinking e Pane de Recusa: Passou mais de um minuto pensando sobre ferramentas, travou sua lógica interna e recusou-se a responder ou traduzir. |
| 14º | Qwen 3:1.7B (Sem Raciocínio) | Alibaba | 1.7 Bilhão | ~4.3 tokens/s | Regular | Delírio Factual Geral: Afirmou que a Espanha e Itália falam português, colocou a Sagrada Família em Madrid e estimou o custo total em irreais R$ 1.400. |
Discussão e Descobertas de Arquitetura de IA
Os testes em hardware com largura de banda de memória limitada (DDR3) revelaram fenômenos críticos sobre a engenharia de software atual das IAs de borda:
A. O Impacto Destrutivo do "Overthinking" Local
O estudo comprovou que a tendência atual de embutir Cadeias de Pensamento (CoT - Chain of Thought) em modelos ultracompactos (família Qwen 3/3.5) é inviável para execução interativa local em CPU. No cenário 5, o Qwen 3.5:2B demonstrou inteligência conceitual ao processar seu rascunho interno em inglês para traduzir a saída de forma limpa para o português, mas o custo disso foram 9 minutos de CPU em estresse total. Para o usuário final na borda, a latência anula o ganho de privacidade ou autonomia.
B. O Paradoxo do Raciocínio Desligado
Ao desligar o mecanismo de Thinking dos modelos hibridizados da Alibaba (Qwen) para recuperar velocidade de escrita, os modelos sofreram um colapso imediato de ancoragem factual. Sem os freios e contrapesos do processamento oculto, o Qwen 3.5 entrou em loop de repetição textual obsessiva (preso em rodovias portuguesas, esquecendo a Itália e a Grécia) e o Qwen 3:1.7B operou delírios geográficos graves (trocando idiomas oficiais de nações europeias). Isso prova que esses modelos menores não possuem conhecimento de mundo consolidado em seus pesos base, dependendo umbilicalmente do tempo gasto "pensando" para ajustar seus parâmetros em tempo de execução.
C. A Engenharia Superior de Tokenização do Google no Gemma 3.
O sucesso estrondoso do Gemma 3:1B (sustentando confortavelmente 10.7 tokens por segundo em leitura fluida e confortável em uma CPU de 2017) reside primariamente em seu tokenizador nativo de 262K.
Modelos como o Llama e o Phi quebram termos em português em múltiplos fragmentos menores porque suas matrizes de vocabulário focam maciçamente no inglês. Como consequência, para processar a palavra "planejamento", esses modelos realizam múltiplos ciclos de leitura e escrita na RAM DDR3 lenta. O Gemma 3 enxerga palavras e sílabas latinas de forma íntegra, reduzindo drasticamente o consumo do cache e contornando o gargalo físico do hardware legado.
Conclusão
Para usuários, desenvolvedores e entusiastas que buscam implementar assistentes inteligentes locais rodando estritamente em CPU de computadores de uso comum ou laptops antigos através do ecossistema Docker + Ollama, a métrica isolada de contagem de parâmetros ou benchmarks matemáticos de nuvem é ela mesma uma ilusão.
Modelos maiores de 3B ou 3.8B (como Phi-4 ou Llama 3B) geram um peso computacional severo que derruba a performance para taxas inutilizáveis de 2 a 3 tokens por segundo na arquitetura DDR3 2133, sem entregar um incremento proporcional em inteligência prática. Modelos hiper-otimizados para código e agentes (família Qwen) sofrem de vieses severos de chamadas de função e latência insustentável.
O Gemma 3:1B do Google consolidou-se como o campeão indiscutível e a escolha padrão para IA de borda em hardware de consumo. Ele provou que uma calibração refinada de instruções, um vocabulário multilíngue nativo robusto e uma arquitetura focada no alinhamento humano e na "empatia de design" conseguem extrair uma experiência de uso rápida, interativa e cognitivamente útil de uma máquina fabricada há quase uma década.